frontier LLM の精度を、Jev の速さで実現する 4B のオープンモデル、Reflex-1
GitHubで見る課題
業務の分類や判定に AI を使う場合、GPT-5.6・Gemini 3.8 などの frontier LLM は精度が高い一方で、1 問に 1〜3 秒かかり、クラウドでの従量課金になります。判定専用 AI の Jev は 0.3 秒と速いものの、推論が要る判定では精度が崩れ、画像には対応していません。どちらも重みが公開されていないため、自社の判定を後から学習させることもできません。
解決策
Google Gemma 4 E4B をベースに、分類の判定と、latent reasoning(推論を文章として書き出さず、モデルの内部で進める手法)による推論を備えた 4B のオープンモデル Reflex-1 を開発しました。要求は Jev と互換の形で、判定ごとに追加学習(LoRA + 潜在推論用の小さな部品)すれば、推論が要る自社特有の判定も、同じ速さで扱えるようになります。考えた各段は、あとから言葉に戻して確かめられます。
成果
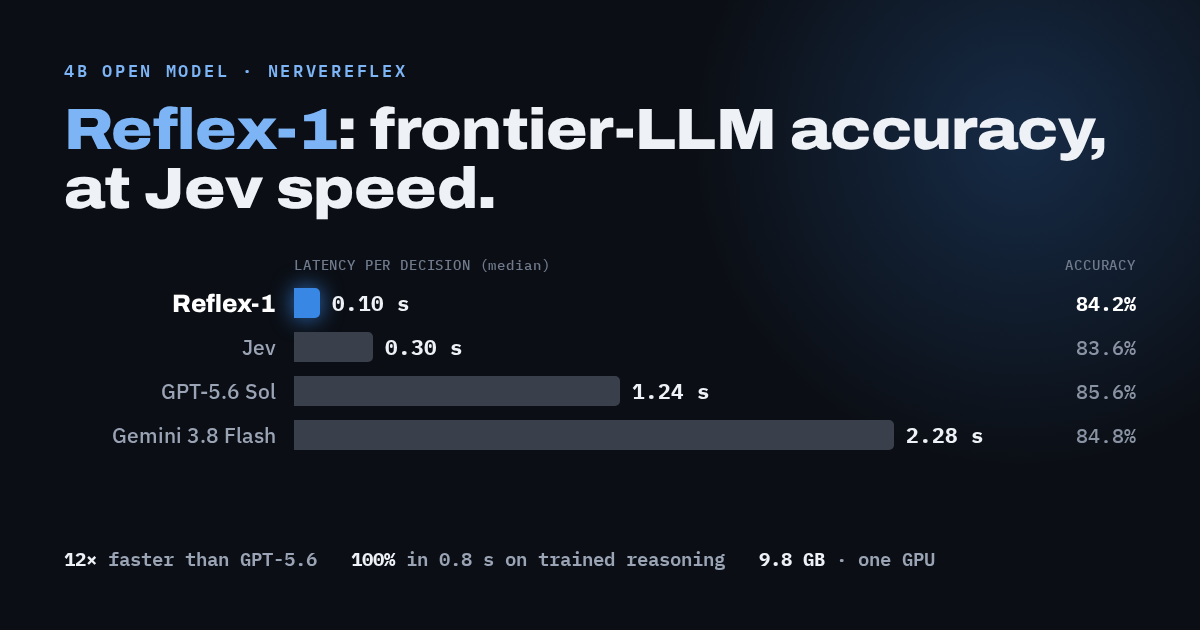
分類の判定では frontier LLM と同じ精度帯のまま、1 判定 0.10 秒(中央値)と GPT-5.6 より 12 倍速く、Jev(0.30 秒)より速い応答になりました。追加学習した推論の判定(10 段の論理パズル)では、frontier LLM が 2.7 秒で出す 100% の精度を 0.8 秒で出しています。重みは 4bit で 9.8 GB と GPU 1 枚に載り、画像も読めます。開発は個人の環境(GX10 1 台)で 4 日、外部の費用は比較用の API 代 約 2.5 ドルでした。
Reflex-1 は、研究プロジェクト NerveReflex(AI モデルを、言葉ではなく内部表現のまま協調させる AI アーキテクチャの研究)の考え方を、実際に使えるオープンモデルとして形にした派生の成果です。
分類の判定では GPT-5.6・Gemini 3.8 などの frontier LLM と同じ精度帯の答えを、判定専用 AI の Jev より速く返し、自社の判定を追加学習すれば、推論が要る判定でも frontier LLM 並みの精度を Jev 並みの速さで出します。手元の GPU で動き、画像も読めます。個人の開発環境で、数日、数ドルで作りました。
分類の判定: 精度はそのまま、速さは桁違い
問い合わせの振り分け、SNS の感情、投稿の審査など、業務で使う分類を同じ問題・同じ選択肢で比べました。精度は 4 者とも同じ帯に並び、答えが返るまでの時間だけが桁で違います。
推論が要る判定も、追加学習で frontier LLM の精度を Jev の速さで
Jev は速いものの、推論が要る判定では崩れます。frontier LLM は reasoning ありなら正確ですが、1 問に数秒かかります。Reflex-1 は latent reasoning(推論を文章として書き出さず、モデルの内部で進める手法)でこの 2 つを両立します。判定を追加学習させると、推論が要る判定でも frontier LLM 並みの精度を、Jev と同じ 1 秒前後で返します。考えた各段は、あとから言葉に戻して確かめられます。下の図は、推論が要る論理課題 5 種で学習させた結果です。
自社特有の判定も、学習させれば同じ速さで使える
この推論は課題ごとの追加学習で身につけたもので、どんな推論にもそのまま効くわけではありません。逆に言えば、請求書と発注書の突き合わせ、承認経路の判定、規程どおりかの確認など、自社特有の判定も、同じ方法で学習させれば、同じ速さで推論できるようになります。重みが公開されていない Jev や frontier LLM には、このように自社の判定を学習させることはできません。
frontier LLM・Jev とどう違うか
| frontier LLM GPT-5.6 / Gemini 3.8 | Jev typesafe/jev-1.13 | Reflex-1 | |
|---|---|---|---|
| 即答の判定 | ▲精度は高いが 1〜3 秒 | ●同じ精度帯・0.3 秒 | ●同じ精度帯・0.1〜0.2 秒 |
| 推論が要る判定 | ▲reasoning ありなら正確、数秒 | ×崩れる | ●約 1 秒(追加学習した判定) |
| 自社特有の判定を学習させる | ×できない | ×できない | ●追加学習できる |
| 推論の中身を確かめる | ●reasoning の出力を読む | ×— | ●潜在ステップを言葉に戻す |
| 画像 | ●対応 | ×非対応 | ●1 枚 約 0.2 秒 |
| 手元で動く・軽さ | ×クラウドのみ | ×クラウドのみ | ●GPU 1 枚、4bit で 9.8 GB |
| 重みの公開 | ×非公開 | ×非公開 | ●公開 |
| 1 回ごとの料金 | ×従量課金 | ×従量課金 | ●なし |
| 要求の形式 | ▲チャット | ●Decisions API | ●Jev と同じ形 |
評価: frontier LLM・Jev・Reflex-1 の比較
同じ問題集・同じ選択肢で比較しています。Jev と Reflex-1 は全問(分類は各 200 問、推論は各 100 問)、frontier LLM はその中から選んだ参考値(分類は各 100 問、推論は各 50 問)です。数字は正解率 %、括弧はレイテンシです。
即答の判定(文章)
文章と選択肢を渡し、1 つ選ばせます。問い合わせをどの窓口に回すか / 音声アシスタントへの日本語の発話の意図 / SNS 投稿の感情(4 種)と肯定・否定・中立(3 種)/ コメントが他人への悪口か(投稿の審査)。
| タスク | frontier LLM | Jev | Reflex-1 | |
|---|---|---|---|---|
| GPT-5.6 Sol | Gemini 3.8 Flash | |||
| 意図分類(CLINC150) | 97 | 96 | 96.5 | 93.5 |
| 日本語の発話意図(MASSIVE) | 96 | 96 | 92.5 | 90.0 |
| SNS の感情(tweet_eval) | 84 | 79 | 81.0 | 82.0 |
| SNS の肯定・否定・中立(tweet_eval) | 78 | 77 | 74.5 | 74.5 |
| 投稿の審査: 他人への悪口か(civil_comments) | 73 | 76 | 73.5 | 80.0 |
| レイテンシ中央値(秒) | 1.1–1.3 | 2.1–2.6 | 0.30 | 0.09–0.21 |
即答の判定(画像)
写真を 1 枚渡し、種類を選ばせます。料理の写真(10 種)/ EC サイトの商品写真(10 種)/ スキャンした書類の種類(16 種)。
| タスク | frontier LLM | Jev | Reflex-1 | |
|---|---|---|---|---|
| GPT-5.6 Sol | Gemini 3.8 Flash | |||
| 料理写真(Food-101、10 種) | 98 | 98 | — | 98.5 |
| EC 商品画像(10 種) | 90 | 96 | — | 83.0 |
| 書類種別(RVL-CDIP、16 種) | — | — | — | 58.0 |
| レイテンシ中央値(秒) | 1.8–2.0 | 2.9–3.1 | — | 0.21–0.26 |
推論(追加学習した論理課題)
推論が要る論理パズルを解かせます(Reflex-1 は課題ごとに追加学習)。嘘つきの連鎖: 「前の人は嘘つき / 正直」と順に言う 10・20 人の最後の人が正直か / 入れ替え追跡: 7 人が 14 回ボールを交換した後、指定の人が持つボール / 真偽式: not・and・or の式の値 / 道順: 指示どおりに歩くと出発点に戻るか。
| タスク | frontier LLM | Jev | Reflex-1 | |
|---|---|---|---|---|
| GPT-5.6 Sol reasoning なし | Gemini 3.8 Flash reasoning あり | |||
| 嘘つきの連鎖 10 段 | 46 | 100 (2.7 s) | 59.0 | 100 (0.8 s) |
| 嘘つきの連鎖 20 段 | 50 | 100 (3.1 s) | 58.0 | 72 (1.5 s) |
| 入れ替え追跡 7 人・14 手 | 10 | 100 (3.5 s) | 26.2 | 70 (1.2 s) |
| 真偽式(BBH) | 92 | 100 (2.4 s) | 98.9 | 100 (0.4 s) |
| 道順(BBH) | 78 | 100 (2.5 s) | 98.2 | 80.8 (0.5 s) |
| レイテンシ中央値(秒) | 1.2–1.3 | 2.4–3.5 | 0.30 | 0.4–1.5 |
使い方
要求は Jev と互換の形(state・questions・instructions・criteria、choice 型)です。mode・skill・trace・image・text 型は Reflex-1 独自の拡張です。
POST /v1/decisions
{"state": "I want to know my credit rating",
 "questions": {"desk": {"type": "choice",
   "instructions": "Which desk should handle this inquiry?",
   "criteria": {"credit_score": "", "transfer": "", "none": "none of these"}}}}
→ {"answers": {"desk": {"choice": "credit_score", "confidence": 0.97,
     "probs": {"credit_score": 0.97, "transfer": 0.01, "none": 0.02}}}, "latency_ms": 90}

{"state": "Question: Ryan tells the truth. Michael says Ryan lies. ...",
 "mode": "deep", "skill": "web_of_lies", "trace": true, "questions": {...}}
→ {"answers": {"a": {"choice": "No", "confidence": 1.0,
     "trace": ["start -> Ryan tells the truth", "Michael says Ryan lies -> Michael lies", "..."]}},
"latency_ms": 820}- GitHub — matu79go/reflex-1
- Hugging Face — matu79go/Reflex-1-4B(4bit 版: Reflex-1-4B-bnb-4bit、Collection)
- Open in Colab
引用: Suzuki, G. (2026). Reflex-1: frontier-LLM accuracy at Jev speed with a 4B open model. Zenodo. doi:10.5281/zenodo.23005201
開発環境
大規模な計算クラスタは使わず、手元の GPU マシン 1 台(ASUS Ascent GX10)で開発しました。学習・評価・動画の作成まで、すべてこのマシンで行っています。
| 項目 | 内容 |
|---|---|
| マシン | ASUS Ascent GX10 × 1 台(NVIDIA GB10 Grace Blackwell、CPU 20 コア、CPU と GPU で共有する統合メモリ 128 GB) |
| OS / ソフト | Ubuntu 24.04 (aarch64) · PyTorch 2.14 (CUDA 13) · Transformers 5.17 · PEFT 0.21 (LoRA) · bitsandbytes 0.50 · vLLM 0.19 |
| ベースモデル | Google Gemma 4 E4B (Apache 2.0) |
| 追加学習 | LoRA + 潜在推論用の小さな部品。1 課題あたり GPU 1 枚で 1.4〜2.2 時間 |
| 開発期間 | 4 日。比較の計測を含む |
| 外部の費用 | 比較用の API 代(Jev・GPT-5.6・Gemini 3.8)合計 約 $2.5。学習にクラウドは使っていない |
注記
- 推論が要る判定は、判定ごとの追加学習が前提です。学習した種類・深さの判定で力を発揮し、学習していない種類の推論にはそのまま効きません。分類の判定は追加学習なしで使えます。
- 推論モードは現在 NVIDIA GPU(CUDA)で動作します。llama.cpp など一般的な実行環境への対応を近日中に進めます。
Reflex-1 の土台になった考え方と、これまでの検証は NerveReflex のプロジェクトページにまとめています:
計測: 2026 年 9 月、GX10(NVIDIA GB10)1 台。Jev(typesafe/jev-1.13)と frontier は OpenRouter 経由、API 実費は合計 約 $2.5。Reflex-1 は Google Gemma 4 E4B(Apache 2.0)からの派生で、Google の公認・関与はありません。Jev は TypeSafe AI の製品で、比較結果は筆者が OpenRouter 経由で測ったものです(TypeSafe AI の公認ではありません)。データ: CLINC150(Larson ら 2019、CC BY 3.0)、MASSIVE(FitzGerald ら 2022、CC BY 4.0)、Civil Comments(Jigsaw、CC0)、BIG-Bench Hard(Suzgun ら 2022、MIT)、tweet_eval(Barbieri ら 2020)、Food-101(Bossard ら 2014)、Fashion Product Images、RVL-CDIP(Harley ら 2015)。動画の写真は Wikimedia Commons の CC0 / パブリックドメイン。コンセプト: NerveReflex。
この記事についてのLinkedIn投稿でコメントや意見を共有できます。
LinkedInで議論する