第1回 話題のAI「Jev」は何がすごいのか? NerveReflexとオープンモデルで再現に成功
はじめに ― Jevの発表
2026年9月15日、ChatGPTの共同開発者であるディオゴ・アルメイダ(Diogo Almeida)氏が、2年間のステルス開発を経て、新しいタイプのAIモデル「Jev(ジェブ)」をX上で発表しました。発表ポストでは、Jevについて次のように説明されています。
• 20-200x faster • 40-400x cheaper (w/ output tokens free) • Frontier composable intelligence optimized for decisions
この発表はSNS上で大きな反響を呼び、発表ポスト以外にも、次のような内容が拡散されています。
SNS上で拡散されている内容(発表ポスト本文には含まれていないもの)
- 入力は100万トークンあたり0.042ドル
- 最大255個の選択肢から判定を返す
- 構造上、ハルシネーションが起きない
- フロンティアモデルの平均的な判断との一致率は67.8%
- 「約5,000回リクエストしても2ドルしかかからなかった」
本稿では、これらの数字や触れ込みをそのまま前提にはせず、発表で示されている「判断に特化したモデル」という方向性が、技術的にどういう仕組みで速さと安さにつながるのかを整理します。
この「文章を生成させず、モデル内部から判定と確率を直接取り出す」という方向性は、私が2026年5月から研究・公開してきたアーキテクチャ「NerveReflex」と考え方が共通しています。そこで後半では、手元のワークステーションとオープンモデルを使って同じ方向性の仕組み(本稿では「Open Jev」と呼びます)を動かした検証結果を紹介します。
1. 判断に特化したモデルとは
普段使われているChatGPTなどのLLMは、「人間向けに文章をトークン単位で順番に書き出すAI」です。
これに対して、Jevが掲げる「decisions(判断)に最適化したモデル」は、プログラム向けに判断だけを返すAIと整理できます。
- 入力: 文章やデータと、「これはAですか、Bですか」という問い
- 出力: あらかじめ指定した選択肢のうちどれに当たるかという「判定結果」と、その「確率(確信度)」
flowchart LR
    subgraph LLM["従来のLLM"]
        A1["問い合わせ文"] --> B1["文章を理解"] --> C1["「承知しました。この件は請求に関する…」<br/>(文章をトークン単位で出力)"]
    end
    subgraph DEC["判断特化モデル"]
        A2["問い合わせ文"] --> B2["文章を理解"] --> D2["{ category: billing, confidence: 0.94 }<br/>(判定と確率だけを返す)"]
    end
※ 図の出力例は説明用のものです。
2. なぜ速く、安くなるのか ― 仕組みの整理
Jevの内部構造は公開されていません。ここでは、一般的なLLMの計算の仕組みから、判断に特化すると速さと安さにつながる理由を整理します。
LLMのコストの多くは「文字を書き出す処理」にかかっている
LLMの推論には、大きく分けて2つの段階があります。
- プリフィル(Prefill / 入力を読む): 送られてきた文章を、まとめて並列に読み込む処理です。GPUにとって効率が良く、時間もコストも比較的かかりません。
- デコード(Decode / 文字を書く): 「次の1トークン」を予測し、その結果を使ってまた「次の1トークン」を予測する、という処理を何十回、何百回と繰り返します。前のトークンが決まらないと次を計算できないため並列化しにくく、GPUのメモリと時間を最も多く使う部分です。
flowchart LR
    IN["入力文<br/>(数百〜数千トークン)"] --> PF["Prefill<br/>1回の並列計算"]
    PF --> HS["hidden state<br/>(理解した結果)"]
    HS --> D1["Decode 1"] --> D2["Decode 2"] --> D3["…"] --> DN["Decode N"]
    DN --> OUT1["文章として出力"]
    HS -.->|"判断特化 / NerveReflex"| OUT2["判定+確率を直接読む<br/>(Decode なし)"]
クラウドLLMの料金で、出力トークン単価が入力トークン単価より高く設定されていることが多いのは、このためです。
文字を生成しなければ、出力側のコストはほとんど発生しない
質問文を読み込んだ時点で、モデルの内部(hidden state:隠れ状態と呼ばれる数値の集まり)には、すでに理解した結果が存在しています。そこから選択肢ごとの確率を1回の計算で取り出せば、デコードを繰り返す必要がありません。
発表ポストにある「output tokens free」も、私の視点では、文章を生成しない設計であれば出力側の計算コストがほとんど発生しない、という構造から自然に説明できるものだと考えています。
3. 拡散されている内容をどう読むか
SNS上で拡散されている内容について、技術的な観点から整理します。数値そのものは私が検証したものではないため、ここでは仕組みから見て妥当かどうかに絞ります。
| 触れ込み | 仕組みから見た評価 | 補足 |
|---|---|---|
| 大幅に速い | 妥当 | デコードをしなければ、応答時間は大きく短くなる |
| 大幅に安い | 妥当 | 出力側の計算がほぼ不要になるため、コスト構造が変わる |
| 出力形式が崩れない | 妥当 | 選択肢以外を出力する経路がなければ、形式エラーは起きない |
| ハルシネーションが起きない | 言い過ぎ | 「形式エラーが起きない」ことと「判断を誤らない」ことは別 |
「ハルシネーションが起きない」について
判断だけを返す設計では、決められた選択肢以外の文字列を出力するエラーは起きません。従来のLLMに「JSONで出力してください」と頼んだときに形式が崩れる、といった問題は避けられます。
しかし、それは「AとBの判定を間違えない」という意味ではありません。上で引用した一致率67.8%という数値が正しければ、約3割のケースではフロンティアモデルと判断が一致していないことになります。判断特化のモデルでも、誤った選択肢を高い確信度で選ぶことは十分にあり得ます。この点は、後半の Open Jev の検証でも確認できます。
4. NerveReflexでの取り組み
「文章を出力させず、内部表現から直接判断を取り出す」という方針は、私が2026年5月に公開した研究プロジェクト「NerveReflex」の基本方針でもあります。
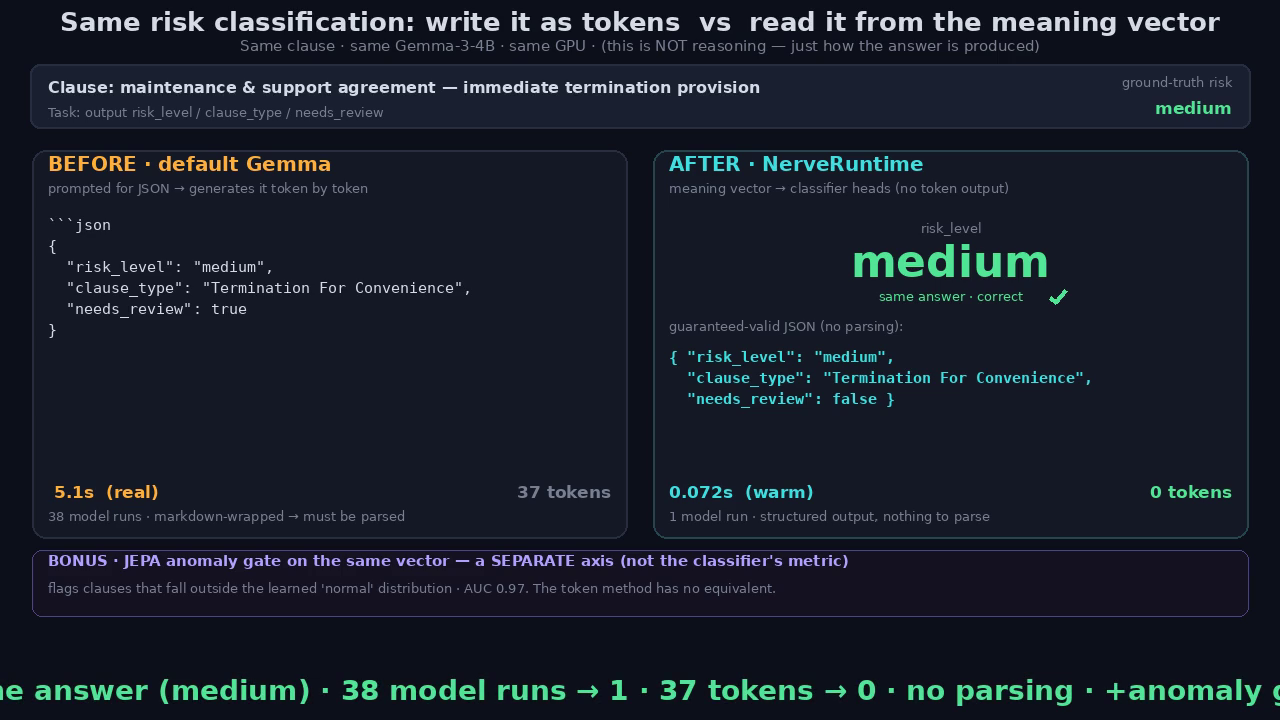
業務の仕分けや分類のたびに、AIが毎回文章を組み立てる必要はない、というのがNerveReflexの出発点です。5月の検証では、同じ契約条項のリスク分類を2つの方式で比較しました。
| 比較項目 | 通常のGemma(文章で出力) | NerveReflex(内部表現で分類) |
|---|---|---|
| 出力の出し方 | JSONをトークン単位で生成 | 内部表現(hidden state)を直接読む |
| 生成トークン数 | 37トークン | 0トークン |
| モデル実行回数 | 38回(読む1回+書く37回) | 1回(読むだけ) |
| 所要時間 | 約5秒 | 約0.07秒(約70倍高速) |
| 出力形式 | 自由文(パースが必要で、崩れうる) | 確定した構造(崩れない) |
5. オープンモデルで「Open Jev」を検証する
Jevのモデルやソースコードは公開されていません。ただ、原理が分かっていれば、オープンモデルを使って手元のワークステーション上で同じ仕組みを再現できます。
今回は単一のワークステーション(ASUS Ascent GX10)上で、オープンモデル「Gemma 4 26B」を推論基盤 vLLM で動かしました。vLLMの制約付き出力機能を使い、「文章を書かせず、1トークン分の計算で選択肢ごとの確率だけを取り出す」構成(Open Jev)を作り、法務契約書のデータで性能を検証しました。
flowchart LR
    C["契約条項<br/>(約540文字)"] --> G["Gemma 4 26B<br/>on vLLM"]
    G -->|Prefill| H["hidden state"]
    H --> L["選択肢 4 つに制約した<br/>1 トークン分の確率"]
    L --> P["リスク判定+確信度"]
    P --> T["温度較正"]
なお、5月の検証(Gemma 3 4B、分類ヘッド方式)と今回(Gemma 4 26B、vLLMの制約付き出力)ではモデルも実装も異なるため、所要時間の数値は直接比較できません。
実測結果1:速度の比較(同じモデル、同じ約540文字の契約条項)
モデルも入力も同じです。差を生んでいるのは、文字をトークン単位で書き出す処理を行ったかどうかだけです。
実測結果2:精度・速度・費用の比較(フロンティアモデルとの比較)
契約条項239件のリスク判定における実測値です。
| モデル | 動作条件 | 正解率 | 応答時間 | 239件の費用 |
|---|---|---|---|---|
| Gemma 4 26B(Open Jev) | ローカル(思考なし・1トークン判定) | 74.1% | 0.11秒 | 0ドル(API費用なし) |
| Claude Sonnet 5 | クラウドAPI(思考なし・1トークン判定) | 77.0% | 2.17秒 | 0.47ドル |
| Claude Fable 5.1 | クラウドAPI(思考あり) | 80.0% | 6.06秒 | 約3.8ドル |
- 思考なし同士の比較: クラウドのClaude Sonnet 5と、手元で動かしたオープンモデルの正解率の差は2.9ポイント(77.0%と74.1%)でした。応答時間は、手元のオープンモデルのほうが約20倍短くなりました。
- 費用: Jevも出力トークンは無料とされていますが、オープンモデルを手元で動かすOpen JevではAPI費用が発生しません(電気代やハードウェアの費用は別途かかります)。
運用の鍵:温度較正で「自信のある判定」だけを自動処理する
AIの出力する確信度は、実際の正解率より高く出がちです。根拠が弱くても「99%」と答えることがあります。
そこで、温度較正(キャリブレーション)と呼ばれる統計的な補正を行い、「確信度90%と出たときは実際に9割程度当たる」状態に近づけました。その結果、次のような運用ルールが成り立つことが分かりました。
flowchart TD
    IN["契約条項"] --> OJ["Open Jev(ローカル)<br/>約0.1秒・API費用なし"]
    OJ --> Q{"較正後の確信度<br/>0.9 以上?"}
    Q -->|"はい(約43%)<br/>正解率 91.7%"| AUTO["自動処理"]
Q -->|"いいえ(約57%)"| ESC["フロンティアモデル<br/>または専門家が確認"]- 確信度の高い4割強の案件は、手元のモデルが約0.1秒、API費用なしで処理する。
- 確信度の低い残り6割弱だけを、フロンティアモデルや人間の専門家に回す。
この構成にすることで、すべての案件をフロンティアモデルで処理する場合と比べて、全体の待ち時間とAPI費用を大きく減らせる見込みです。
6. 考察:フロンティアモデルとは役割が違う
私の視点では、JevやNerveReflexの本質は、既存モデルの出力方法を「文字の生成」から「内部の確率・表現の読み出し」へ切り替えた、シンプルで合理的な設計変更です。
| 深く考えるAI(System 2) | 素早く反応するAI(System 1) | |
|---|---|---|
| 代表例 | フロンティアモデル(思考あり) | Jev、NerveReflex、Open Jev |
| 出力 | 数千トークンの思考過程と文章 | 型付きの判定と確信度 |
| 応答時間 | 秒〜分単位 | ミリ秒単位 |
| 向いている仕事 | 複雑な推論、設計、文章作成 | 仕分け、検知、ルーティング、承認前チェック |
業務システムの多くで必要とされているのは、長い文章ではなく「この申請を通してよいか」「このメールをどの部署に回すか」といった 型付きの判断 です。文章を介さないこの方式は、そうした現場業務の自動化で費用対効果を出しやすいと考えています。
おわりに
Jevの登場によって、「AIに不要な文章を生成させず、内部表現のまま高速かつ安価に判断させる」という考え方に、広く注目が集まりました。
フロンティアモデルのAPIに出力トークン分の費用を払い続けることだけが、AIの使い方ではありません。
オープンモデルを手元の計算資源で動かし、文章を介さない判定を組み合わせることで、大きな資本を持たない個人や中小規模の現場でも、実用的で無駄の少ないAIシステムを作れると考えています。今後も、この非言語で協調するAIアーキテクチャの研究と実装を続けていきます。
- 検証環境: ASUS Ascent GX10(単一ワークステーション)
- 使用モデル: Gemma-4-26B-A4B(FP8)、vLLM
この記事についてのLinkedIn投稿でコメントや意見を共有できます。
LinkedInで議論する