EmbeddingGemma 2 を改良した、スマホで動く動画判定モデル。動画を Jev の速さ・frontier LLM 以上の精度で判定する、Reflex-2
課題
見守りカメラの転倒や防犯カメラの異常、ガラスの割れる音などを AI で判定する場合、Gemini などの frontier LLM は動画を読めるものの、1 回の判定に数秒から十数秒かかり、映像をクラウドに送る必要があります。判定専用 AI の Jev は速いものの、動画を読めません。どちらも重みが公開されていないため、現場の映像や音で判定を学習させることもできません。
解決策
Google が公開した検索用のオープンモデル EmbeddingGemma 2(7.4 億パラメータ)を土台に、判定したいことのお手本を見せて学習させ、動画と音の判定モデル Reflex-2 にしました。学習は判定ごとに数分で終わり、カメラの映像を流し見しながら判定することもできます。問い合わせの形は Jev と同じです。
成果
転倒の判定は 1 回 0.28 秒と Gemini 3.8 Flash(6.95 秒)より 25 倍速く、正答率は 97.5%(Gemini は 85%)でした。音の判定は 0.05 秒で 100% です。カメラの流し見では転んでから 1〜2 秒で気づき、Gemini は 8 秒後か見逃しでした。重みは 1.5 GB でスマホで動く大きさです。開発は手元の GPU マシン 1 台で 2 日、外部の費用は比較用の API 代 約 1.3 ドルでした。
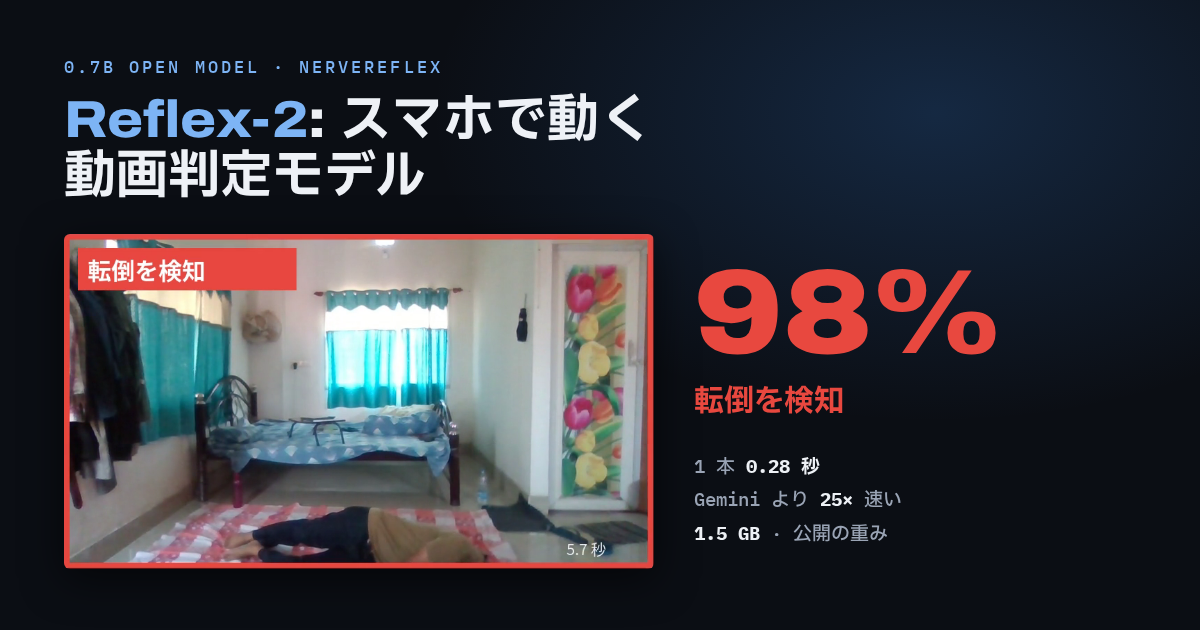
Google が 2026 年 10 月 6 日に公開した検索用のオープンモデル EmbeddingGemma 2 を、動画を判定できるように改良しました。映像をクラウドに送らず、その場で、一瞬で判定します。音の判定もできます。
Reflex-2 は、研究プロジェクト NerveReflex の考え方を実際に使えるオープンモデルとして形にした派生の成果で、文章・画像の判定を扱う Reflex-1 の姉妹モデルです。Reflex-2 の重みは Hugging Face、コードは GitHub で公開しています。
下の 2 本は、Reflex-2 と Gemini 3.8 Flash に同じ映像・同じ音を判定させ、答えるまでの速さと正しさを比べた動画です。
Reflex-2 とは
Reflex-2 は、Google の EmbeddingGemma 2(7.4 億パラメータ、Apache 2.0)を土台に、動画と音を判定できるように改良したオープンモデルです。見守りカメラの転倒、防犯カメラの異常、泣き声やガラスの割れる音など、現場で起きたことを一瞬で見分けます。
土台の EmbeddingGemma 2 は、文字・画像・動画・音を同じ「数の並び」(ベクトル)に変える、検索用のモデルです(Google の発表、開発者向けガイド)。スマホやノート PC で動くように作られています。ただし本来は「似たものを探す」ためのモデルで、素のままでは判定にはほとんど使えません。これを判定に使えるようにしたのが Reflex-2 です。
何がすごいのか
判定専用 AI の Jev は速いものの、動画を読めません。Gemini などの frontier LLM は動画を読めますが、1 回の判定に数秒から十数秒かかり、映像をクラウドに送る必要があります。Reflex-2 は、動画を Jev のような一瞬の速さで、frontier LLM と同等以上の精度で、スマホで動く大きさで判定します。
現場の判定を、お手本から数秒で作れる
転倒・侵入・ガラスの音など、判定したいことのお手本を数十本見せれば、その場で判定器ができます。重みが公開されていない Jev や frontier LLM には、自分の現場の映像や音で判定を学習させることはできません。
どのように動画判定モデルにしたか
素の EmbeddingGemma 2 は、似たものを探す検索用のモデルなので、そのままでは「これは転倒か」といった判定はできません。そこで Reflex-2 では、判定したいことのお手本を見せて学習させます。
学習させないと、精度は出ない
同じ EmbeddingGemma 2 でも、お手本で学習させる前と後では、精度がまったく違います。学習は数分で終わり、そのあとは学習した判定がそのまま使えます。
下の表は、4 つのお題について、学習に使ったお手本の数、学習にかかった時間、そして学習する前(素の EmbeddingGemma 2)と学習した後(Reflex-2)の正答率を並べたものです。
| お題 | 学習に使ったお手本 | 学習にかかる時間 | 素の EmbeddingGemma 2 (学習なし) | Reflex-2 (学習あり) |
|---|---|---|---|---|
| 転倒 | 約 120 本 | 約 1 分 | 正答率 53.8% | 正答率 95.7% |
| 防犯カメラの異常 | 120 本 | 約 3 分 | 正答率 63.5% | 正答率 92.5% |
| 音 10 種 | 320 本 | 約 30 秒 | 正答率 35% | 正答率 96.3% |
| 声の感情 8 種 | 1,200 本 | 約 1 分 | 正答率 14% | 正答率 52% |
どのように応用していくか
ここからは、実際の現場を想定した 3 つの実例で、Reflex-2 と Gemini 3.8 Flash を同じ条件で比べます。どれも、学習に使っていない映像・音で採点した実測です。
実例 1 — 高齢者の見守り: 転倒をすぐ知らせる
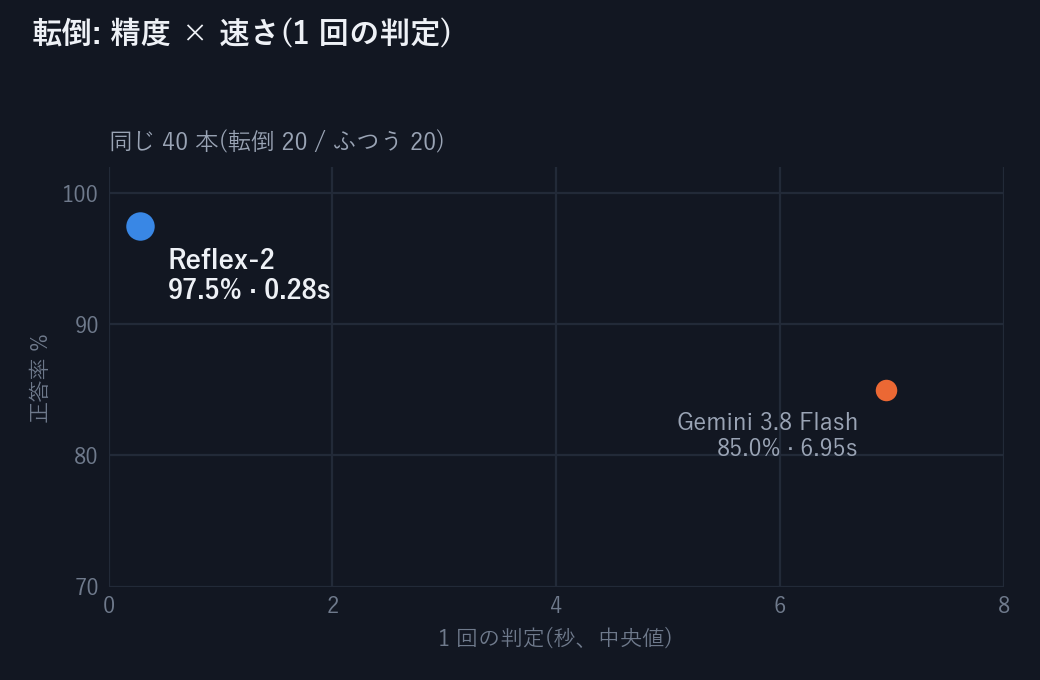
家の中のカメラ映像(GMDCSA24: 3 つの家・4 人・転倒 79 本とふつうの動き 81 本)で、転倒かどうかを判定させました。Reflex-2 は、160 本全体(学習に出ていない人の映像で採点)でも正答率 95.7% です。
| お題(同じ 40 本で比較) | Gemini 3.8 Flash | Reflex-2 |
|---|---|---|
| 転倒か、ふつうの動きか | 85.0% | 97.5% |
| 1 回の判定時間(中央値) | 6.95 秒 | 0.28 秒 |
カメラと同じように流し見させ、転んだ瞬間から何秒で気づけるかも比べました。
| カメラの流し見(同じ映像) | 実際の転倒 | Gemini 3.8 Flash | Reflex-2 |
|---|---|---|---|
| 椅子から落ちる | 3.4 秒 | 転んでから 8.3 秒 | 転んでから 1.9 秒 |
| 歩いて転ぶ | 2.7 秒 | 見逃し(4 回とも「ふつう」) | 転んでから 2.1 秒 |
| 前に倒れ込む | 2.6 秒 | 見逃し(4 回とも「ふつう」) | 転んでから 1.2 秒 |
| ベッドに横になる(ふつう) | — | 誤報なし | 誤報なし |
実例 2 — 防犯カメラ: 侵入や異常に気づく
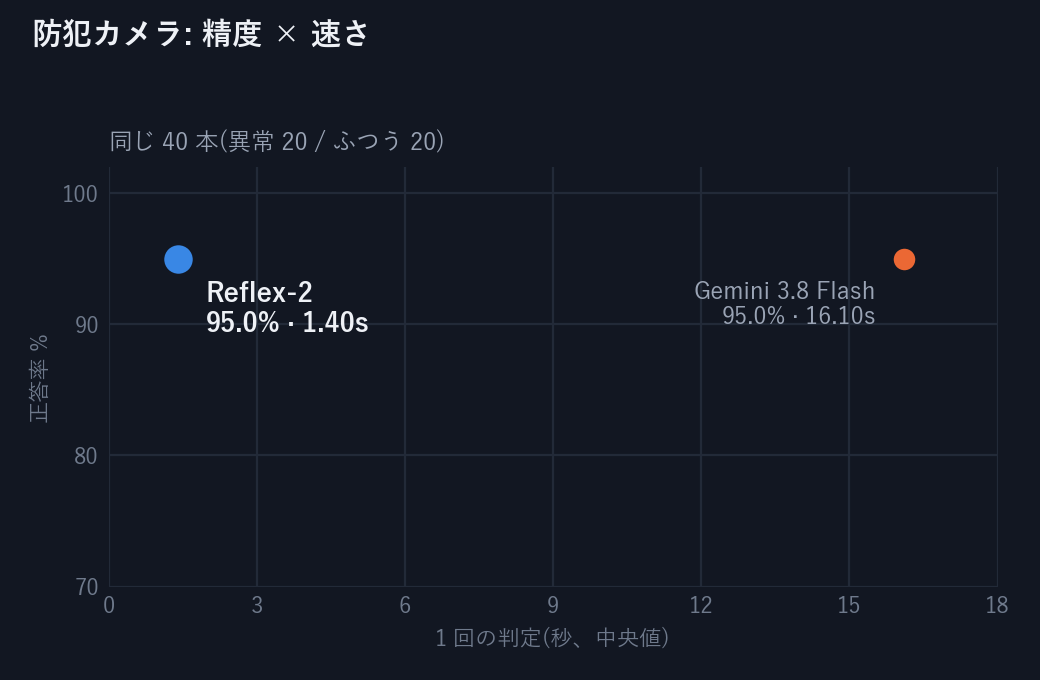
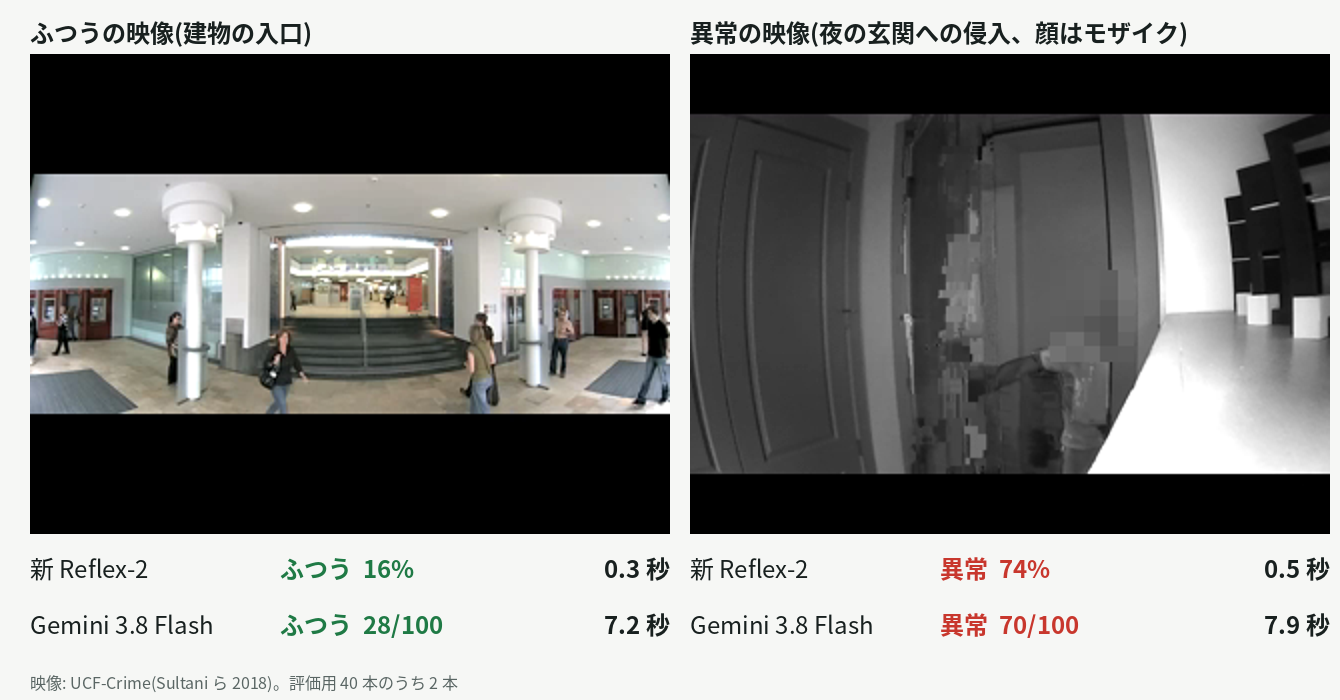
防犯カメラの映像(UCF-Crime)が、侵入・暴行などの異常を含むか、ふつうの日常かを判定させました。Reflex-2 は、評価用の 110 本全体でも正答率 92.5% です。
| お題(同じ 40 本で比較) | Gemini 3.8 Flash | Reflex-2 |
|---|---|---|
| 防犯カメラの映像が、異常か、ふつうか | 95% | 95% |
| 1 回の判定時間(中央値) | 16.1 秒 | 1.4 秒 |
実例 3 — 音: 泣き声・ガラス・警報を聞き分ける
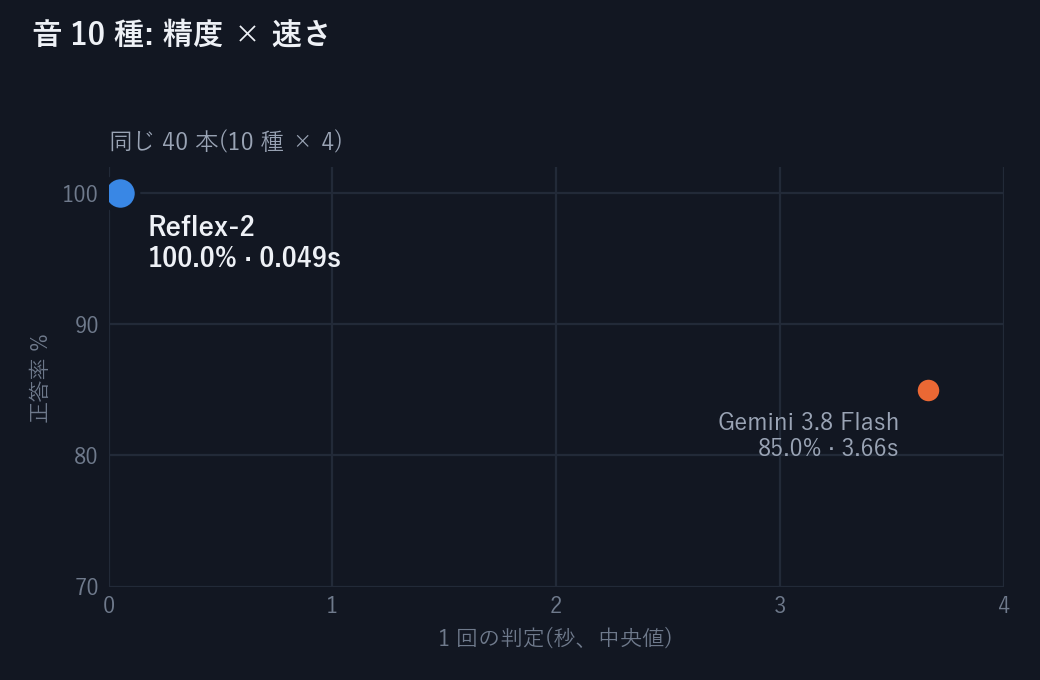
見守りと防犯で大事な 10 種類の音(赤ちゃんの泣き声・ガラスが割れる・サイレン・犬・ドアのノック・足音・咳・いびき・目覚まし・火のパチパチ)を判定させました。Reflex-2 は、400 本全体(学習に使っていない音で採点)でも正答率 96.3% です。
| お題(同じ 40 本で比較) | Gemini 3.8 Flash | Reflex-2 |
|---|---|---|
| 10 種類の音の聞き分け | 85% | 100% |
| 1 回の判定時間(中央値) | 3.66 秒 | 0.05 秒 |
使い道は、ここからさらに広がる
動画と音を、スマホやカメラのそばの機器で、一瞬で、現場のお手本から学んだ基準で判定できます。実測 の印は今回確かめたもので、ほかも同じ方法で作れます。
- 転倒・転落実測
- 夜間の徘徊、長く動かない
- 咳・いびき実測、むせ・うめき声
- ベッドからの起き上がり
- 赤ちゃんの泣き声実測
- 留守中のガラス破損実測・侵入
- 火のパチパチ音実測・目覚まし実測
- ペットの鳴き声実測・異変
- 侵入・暴行などの異常実測
- 閉店後のうろつき
- 万引きらしい動き
- 悲鳴・ガラスの音でかけつけ
- 作業者の転倒・転落
- 立入禁止区域への侵入
- 機械の異音・警報音
- フォークリフトと人の接近
- 事故・落下物
- 駅ホームからの転落
- サイレン実測・警報音
- けんか・群衆の異常な動き
- 置き去りの荷物
- 体調不良で倒れた人
- 家畜の異常行動・出産
- 害獣の侵入
- 鳴き声による体調の変化
- 大量の映像・音声の自動仕分け
- 危険な場面の自動検出
- 映像の中の出来事の検索
映像を外に出さずに済む
家・病院・店・工場の映像は外に出したくないことが多くあります。Reflex-2 はカメラのそばやスマホの中で判定するので、映像をクラウドに送る必要がなく、通信費も 1 回ごとの料金もかかりません。
frontier LLM・Jev・Reflex-1 とどう違うか
| frontier LLM Gemini 3.8 / GPT-5.6 | Jev typesafe/jev-1.13 | Reflex-1 文章・画像 | Reflex-2 | |
|---|---|---|---|---|
| 動画の判定 | ▲精度は高いが 1 本 7〜16 秒 | ×非対応 | ×画像のみ | ●1 本 0.28 秒 |
| 音の判定 | ▲1 本 2〜13 秒 | ×非対応 | ×非対応 | ●1 本 0.05 秒 |
| 転んでから気づくまで | ▲8 秒、または見逃し | ×— | ×— | ●1〜2 秒 |
| 判定の作り方 | ●問いを書く | ●問いを書く | ●問いを書く・学習も可 | ▲お手本を数十本見せて学習 |
| 現場の判定を学習させる | ×できない | ×できない | ●追加学習できる | ●お手本から数秒 |
| 手元で動く・軽さ | ×クラウドのみ | ×クラウドのみ | ●GPU 1 枚、9.8 GB | ●スマホで動く、1.5 GB |
| 重みの公開 | ×非公開 | ×非公開 | ●公開 | ●公開 |
| 1 回ごとの料金 | ×従量課金 | ×従量課金 | ●なし | ●なし |
| 要求の形式 | ▲チャット | ●Decisions API | ●Jev と同じ形 | ●Jev と同じ形 |
評価: Gemini 3.8 Flash との比較
同じ入力(同じコマ、同じ 16 kHz の音)を両方に渡しています。Gemini は思考を切れないモデルのため、考える量を最小にして、数字 1 つか選択肢 1 つで答えさせました。Reflex-2 はお手本で学習させた判定器、Gemini は学習なしです。Reflex-2 は GX10(NVIDIA GB10)の GPU 1 枚、Gemini は OpenRouter 経由(通信込み)で、どちらも 1 本ずつ測りました。
| お題(同じ 40 本) | Gemini 3.8 Flash | Reflex-2 |
|---|---|---|
| 転倒 正答率 / 見逃し | 85.0% / 6 本 | 97.5% / 0 本 |
| 転倒 1 回の判定(中央値) | 6.95 秒 | 0.28 秒 |
| 防犯カメラ 正答率 | 95% | 95% |
| 防犯カメラ 1 回の判定(中央値) | 16.1 秒 | 1.4 秒 |
| 音 10 種 正答率 | 85% | 100% |
| 音 1 回の判定(中央値) | 3.66 秒 | 0.049 秒 |
| 1 本の費用 | $0.0003〜0.023 | 0 |
使い方
試し方は 2 通りあります。手元に環境を用意しなくても、ブラウザだけで試せる Google Colab がいちばん手軽です。
方法 1: Google Colab で試す(インストール不要)
- Colab のノートブックを開きます。
- メニューの「ランタイム」→「ランタイムのタイプを変更」で、GPU(T4 以上)を選びます。
- 上のセルから順に実行します。最初の実行で、土台の EmbeddingGemma 2(1.5 GB)が自動でダウンロードされます。
ノートブックでは、次の 4 つを順に試せます。
- 公開データ(GMDCSA24)の転倒の動画と、ふつうの動きの動画を 1 本ずつ判定する
- 転倒の動画をカメラのように流し見させ、「転倒らしさ」の変化をグラフで見る
- 別の 3 人の動画 12 本(転倒 6 本・ふつう 6 本)をお手本に、自分の判定器を数秒で作る
- 学習なしで「寝室か、台所か」のような簡単な問いを試す
方法 2: 手元のパソコンで試す
Python 3.10 以上が必要です。GPU があれば速く動きますが、なくても動きます。
git clone https://github.com/matu79go/reflex-2
cd reflex-2
pip install -r requirements.txt
① 動画 1 本を判定する。 リポジトリには、学習済みの転倒の判定器(heads/fall.json)が入っています。これを読み込み、手元の動画ファイルを渡すと、転倒かどうかを答えます。
from reflex2 import Reflex2

rf = Reflex2().load_heads("heads")      # 学習済みの判定器を読み込む(初回は土台のモデルを自動でダウンロード)
rf.decide("clip.mp4", "fall")           # clip.mp4 が転倒の場面かどうかを判定する
# {'choice': 'fall', 'confidence': 0.97, 'probs': {'adl': 0.03, 'fall': 0.97}, 'latency_ms': 290}
結果の choice が判定(fall = 転倒、adl = ふつうの動き)、probs がそれぞれの確からしさ、latency_ms が判定にかかった時間(ミリ秒)です。この例では、転倒の確からしさ 97%、0.29 秒で判定しています。
② カメラのように流し見する。 長い動画を渡すと、0.5 秒ごとに直近 4 秒を判定し、時刻ごとの「転倒らしさ」を返します。上の見守りカメラの動画の折れ線は、この結果を描いたものです。
rf.watch("camera.mp4", "fall")
# [(1.0, {'adl': 0.96, 'fall': 0.04}), ..., (4.5, {'adl': 0.03, 'fall': 0.97}), ...]
③ 自分の判定器を作る。 判定したいことのお手本を、種類ごとにファイルのリストで渡します。動画・画像・音のどれでも使えます。下の例は、ガラスが割れる音(glass)とそれ以外の音(other)を見分ける判定器を作り、保存するものです。
head = rf.train_head({"glass": ["g1.wav", "g2.wav", ...], "other": ["o1.wav", ...]}, name="glass")
head.save("heads/glass.json")           # 保存しておけば、次からは load_heads で読み込んで使える
rf.decide("new_sound.wav", "glass")     # 新しい音を判定する
お手本は数十本あれば、学習は数秒から数分で終わります。実際の現場で使う場合は、その現場のカメラやマイクで撮ったものをお手本にするのがおすすめです。
リンク
- GitHub — matu79go/reflex-2
- Hugging Face — matu79go/Reflex-2
- Open in Colab
- EmbeddingGemma 2(Hugging Face)
- EmbeddingGemma 2 の発表(Google)
開発環境
大規模な計算クラスタは使わず、手元の GPU マシン 1 台(ASUS Ascent GX10)で開発しました。学習・評価・動画の作成まで、すべてこのマシンで行っています。
| 項目 | 内容 |
|---|---|
| マシン | ASUS Ascent GX10 × 1 台(NVIDIA GB10 Grace Blackwell、CPU 20 コア、CPU と GPU で共有する統合メモリ 128 GB) |
| OS / ソフト | Ubuntu 24.04 (aarch64) · PyTorch 2.14 (CUDA 13) · Transformers 5.19 · sentence-transformers 6.1 · PyAV |
| 土台のモデル | Google EmbeddingGemma 2(Apache 2.0) |
| 改良 | お手本による学習(判定ごとに数分)・カメラの流し見・Jev と同じ形の問い合わせ口 |
| 開発期間 | 2 日。比較の計測と動画の作成を含む |
| 外部の費用 | 比較用の API 代(Gemini 3.8 Flash)合計 約 $1.3。学習にクラウドは使っていない |
注記
- 判定は、判定したいことのお手本で学習させて使います。 素の EmbeddingGemma 2 のままでは、判定の精度は出ません。
- 分かるのは「いつ・何が起きたか」です。画面の中のどの人かを特定する用途には、人を見つけるモデルと組み合わせます。
- 評価は公開データ(役者が演じた転倒、防犯カメラ映像、効果音)で行いました。実際の現場では、その現場の映像や音をお手本にするのがおすすめです。
Reflex-2 の土台になった考え方と、姉妹モデルの Reflex-1 は、次のページにまとめています:
- NerveReflex ― 非言語で協調するAIアーキテクチャの研究
- frontier LLM の精度を、Jev の速さで実現する 4B のオープンモデル、Reflex-1
- 第1回 話題のAI「Jev」は何がすごいのか? NerveReflexとオープンモデルで再現に成功
計測: 2026 年 10 月、GX10(NVIDIA GB10)1 台。Gemini 3.8 Flash は OpenRouter 経由、API 実費は合計 約 $1.3。Reflex-2 は Google EmbeddingGemma 2(Apache 2.0)を改良したもので、Google の公認・関与はありません。Gemini の結果は筆者が測ったものです。データ: GMDCSA24(Data in Brief 2024、MIT License、出演者 4 人が一般公開に同意)、UCF-Crime(Sultani ら 2018、研究用)、ESC-50(Piczak 2015、CC BY-NC 3.0)、RAVDESS(Livingstone と Russo 2018、CC BY-NC-SA 4.0)。コンセプト: NerveReflex。
この記事についてのLinkedIn投稿でコメントや意見を共有できます。
LinkedInで議論する